


Репликация данных между системами хранения
В современной бизнес-реальности стабильная работа ИТ-инфраструктуры критична для поддержания бесперебойности операций компаний. Одним из ключевых инструментов, гарантирующим надежность и доступность данных, выступает репликация. Далее мы детально разберём понятие репликации данных, её механизмы работы и достоинства.
Основные понятия
Для лучшего понимания деталей приведём базовые определения:
RPO (Recovery Point Objective) — предельно допустимая длительность интервала, за которую могут быть утрачены данные после процедуры восстановления системы. RPO измеряют временем, например минутами или часами, а не объёмом данных в байтах.
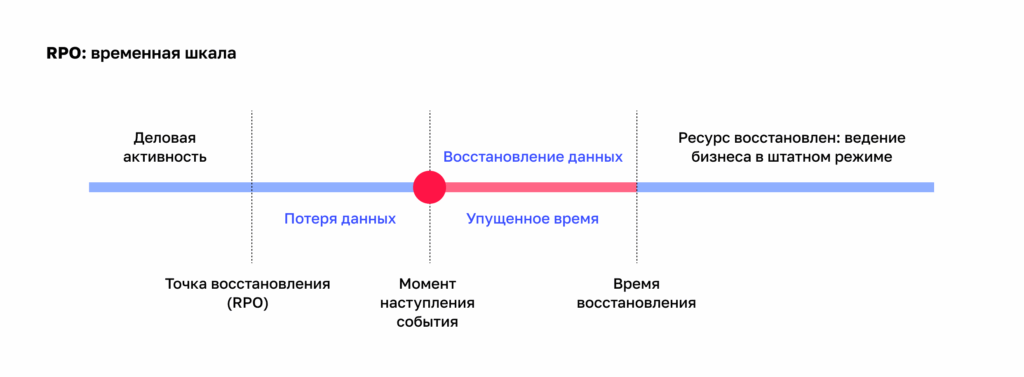
RTO (Recovery Time Objective) — временной промежуток, отведённый на восстановление работоспособности системы после сбоев. Допустимое время вынужденного простоя системы.
Репликация данных
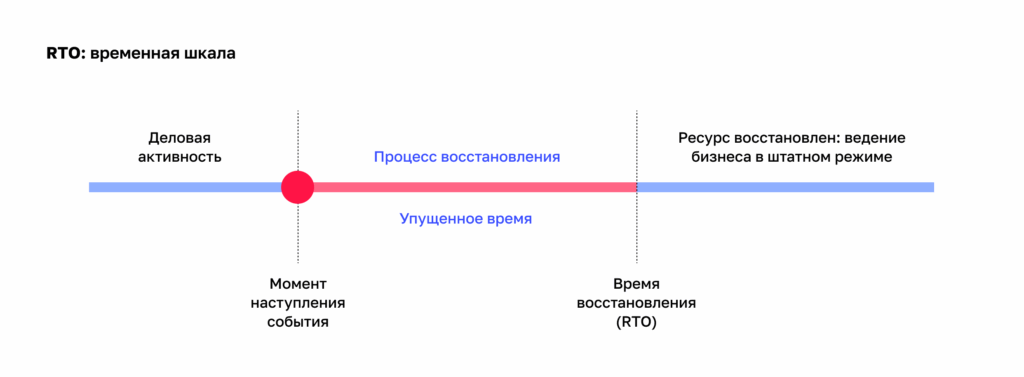
Репликация (replication) представляет собой размещение одинаковых копий данных на нескольких устройствах (СХД, серверах), объединённых сетью. Такая схема обеспечивает избыточность и постоянную доступность данных в ситуации отказа какого-либо элемента системы.
Технология репликации зародилась в ИТ-отрасли в начале девяностых годов прошлого века, когда стало ясно, насколько важна сохранность данных и их доступность. Сегодня репликация прочно вошла в инфраструктуру большинства крупных предприятий, где утрата данных способна нанести серьёзный финансовый ущерб и удар по репутации.
Причины внедрения репликации
Репликация применяется по ряду причин:
- Масштабируемость. Когда нагрузка на чтение-запись возрастает, распределяют её между несколькими серверами, системой хранения данных (СХД) или центрами обработки данных (ЦОД).
- Отказоустойчивость. Важно сохранить работоспособность приложений в случае сбоя оборудования или повреждения диска, обеспечивая устойчивость с помощью резервных ресурсов.
- Минимизация задержек. Чтобы сократить задержки при доступе к данным для глобальных пользователей, оборудование целесообразно размещать ближе к регионам нахождения потребителей.
Процесс репликации предусматривает две основные составляющие: ведущий узел (например, сервер или СХД) и один или несколько подчинённых узлов, принимающих копию данных.
Передача данных между элементами сети может осуществляться тремя основными методами:
- Remote Copy over Fibre Channel (RCFC) — репликация задействует порты Fibre Channel массива, а данные передаются по каналам Fibre Channel.
- Remote Copy over Internet Protocol (RCIP) — используется встроенный интерфейс IP-порта массива, данные отправляются по IP-каналам.
- Remote Copy over FCIP (Fibre Channel over IP) — аналогично RCFC, но передача осуществляется по IP-сети с применением специализированных шлюзов (gateways).
Виды репликации
Есть два главных подхода к репликации:
Синхронная репликация: обновление данных производится мгновенно, операция завершается только после успешной фиксации изменений на всех целевых системах. Такой подход повышает доступность, но иногда снижает общую скорость работы.
Асинхронная репликация: изменения переносятся с небольшой задержкой, снижая нагрузку на систему, но потенциально приводя к небольшому расхождению данных.
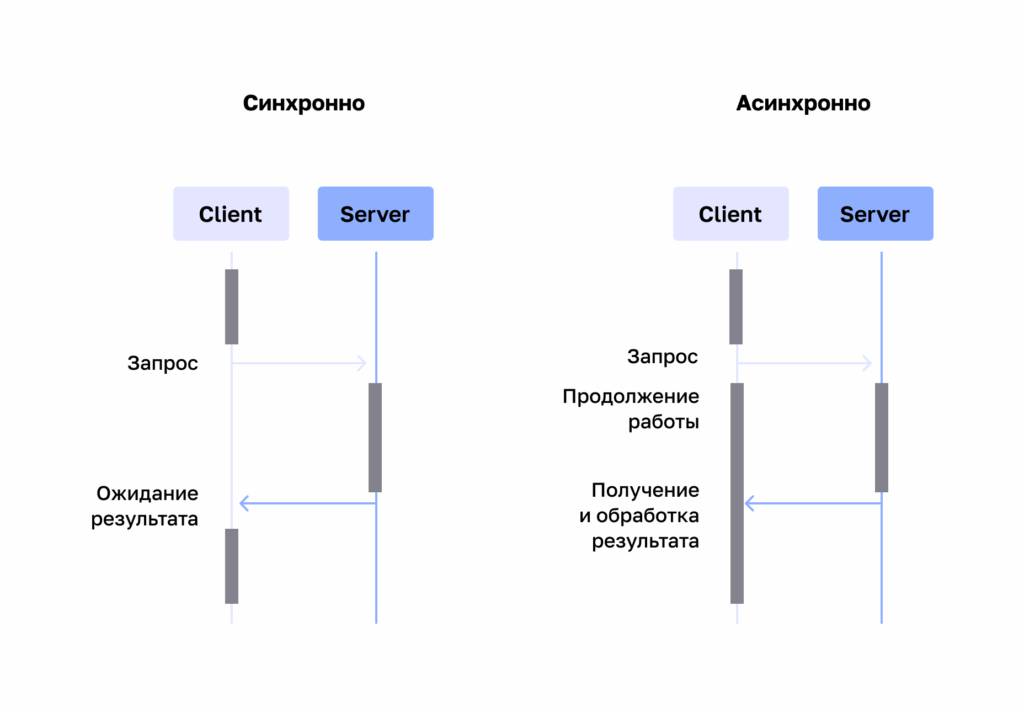
Функционирование видов репликации
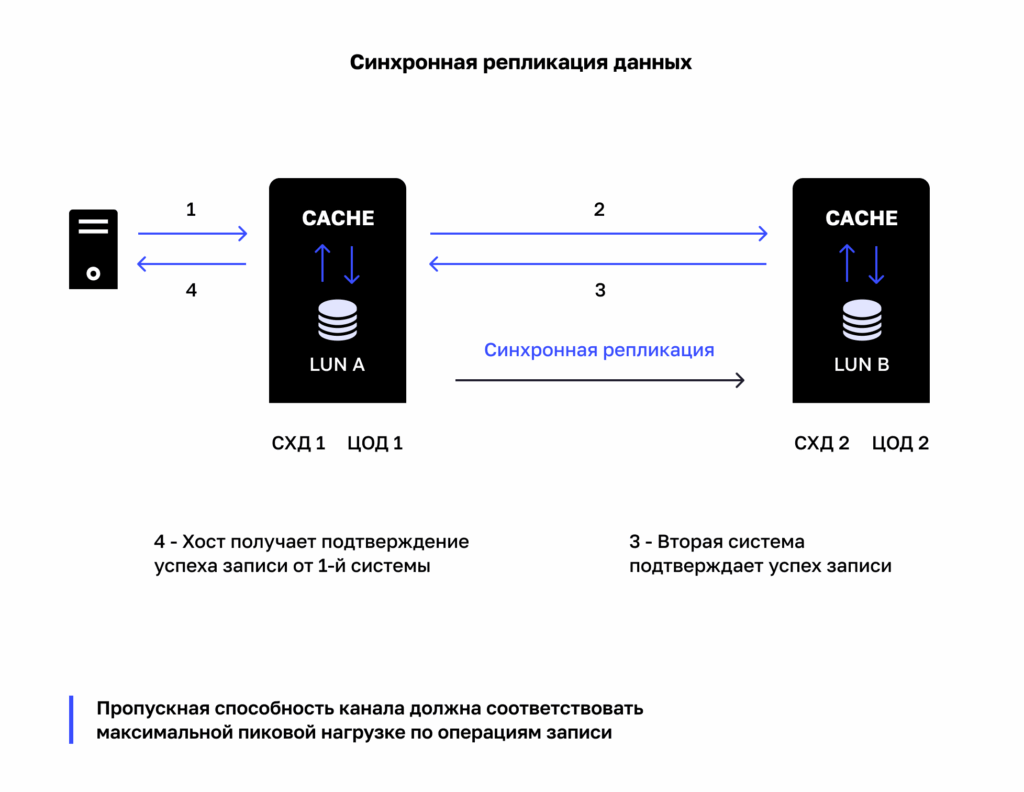
Синхронная репликация
Синхронная репликация чаще реализуется через сети Fiber Channel или Ethernet с использованием протокола iSCSI. Сначала полная копия данных тома направляется на целевой объект (initial data transfer). Так же происходит и при асинхронной репликации.
При синхронной репликации подтверждение записи хосту зависит от её фиксации на обеих сторонах. Поведение при потере связи или отказе второй площадки определяется настройками и реализацией конкретной СХД.
Важно помнить, что стабильность канала передачи данных влияет на задержку репликации, следовательно, расстояние между оборудованием становится существенным фактором при выборе синхронной репликации.
Примечание: для подтверждённых записей синхронная репликация может обеспечивать RPO = 0 при сохранении синхронного режима; это не означает нулевое время восстановления RTO.
Асинхронная репликация
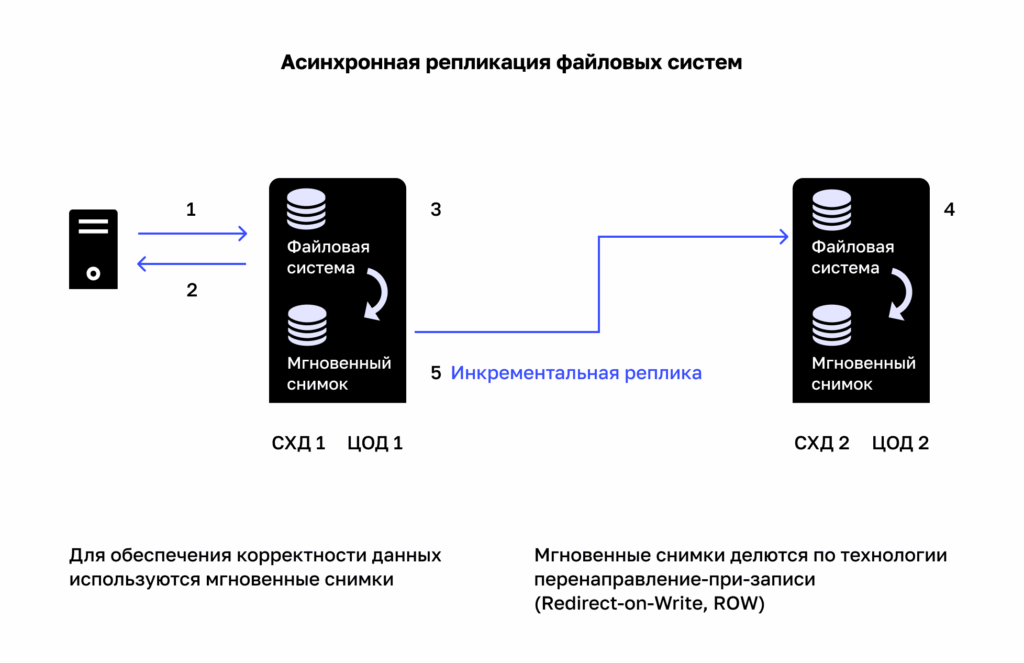
Асинхронная репликация допускает временное отставание реплик от оригинала. Копирование данных происходит через сеть Ethernet с использованием протокола TCP/IP.
Сначала создаётся начальная копия содержимого тома, затем периодически передаются накопившиеся изменения.
Ведущий узел транслирует данные на ведомый узел без ожидания подтверждения. Таким образом, сохраняется высокая пропускная способность, но возможны временные несоответствия между источником и репликой.
Заметим, что минимальный временной интервал между передачами устанавливается заранее.
Совместное использование режимов репликации
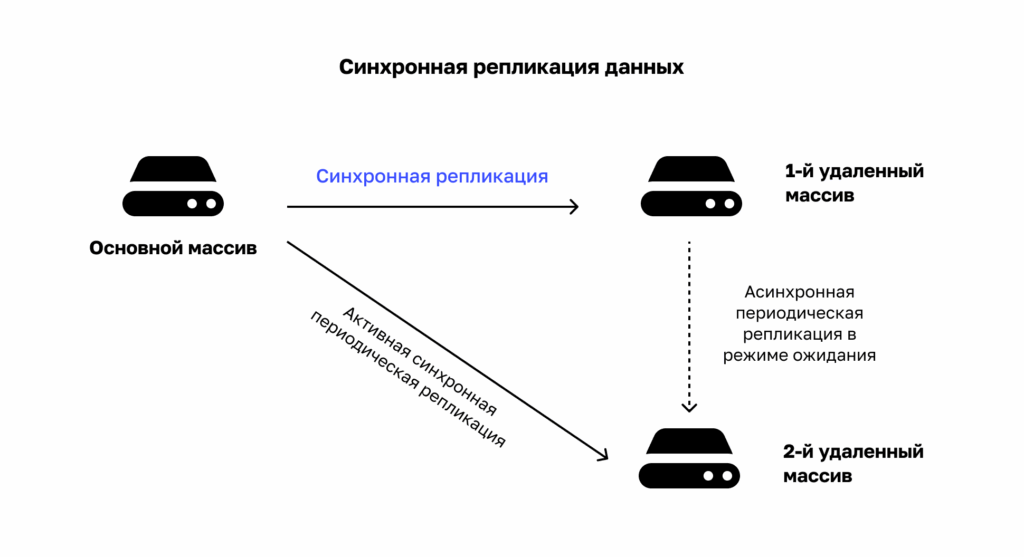
Иногда компании применяют оба типа репликации одновременно. Специальный режим называется Synchronous Long Distance (SLD) и предназначен для дублирования данных на значительные расстояния без риска потерь.
SLD требует наличия специального оборудования и встречается преимущественно среди решений крупных производителей СХД.
Заключение
Репликация данных — мощный инструмент для повышения надежности ИТ-инфраструктуры. Рассмотрев принципы и виды репликации, мы убедились, что грамотная настройка этого инструмента помогает избежать рисков в кризисных ситуациях, справиться с ростом нагрузок и поддерживать постоянное функционирование сервисов. Функционал репликации доступен в системе хранения ATLAS.SM.
Репликация данных: документация и возможности ATLAS
Определение RPO приведено в документации IBM. Поддержка FC и iSCSI в ATLAS описана в материале о синхронной репликации ATLAS.SM. Для защиты от удаления, логических ошибок и шифрования данных дополнительно планируйте независимые резервные копии: эти изменения могут распространяться на реплику.


